最近、Codexの週次利用量が気になるようになった。
複雑な実装や調査に使っているから、というだけではない。短い分類、似た文章の下書き、決まった形式への整形まで、何でも同じようにCodexへ渡していた。
一つずつは小さい。
でも、毎日繰り返すと積み上がる。
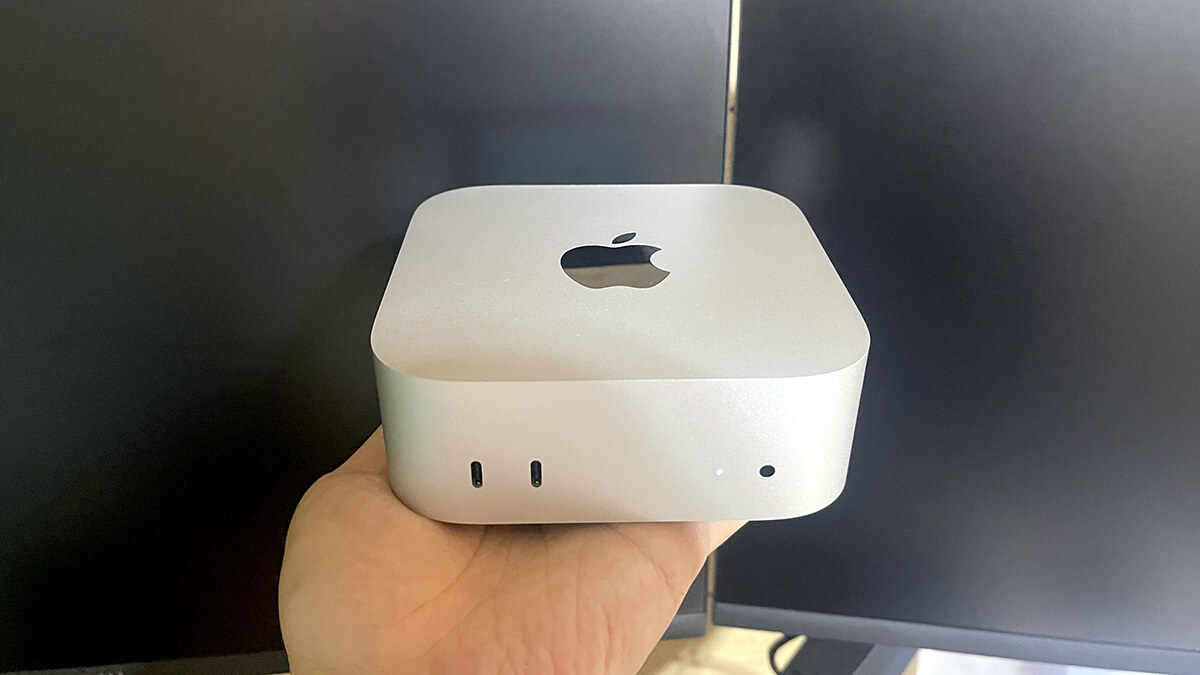
そこで、常時稼働させているMac miniへOllamaを入れ、反復的な分類と短い生成をローカルLLMへ移してみた。
使ったのはqwen3:8b。Ollama本体は常駐させるが、モデルは処理が終わって10分たったらメモリから解放する構成です。
先に結論を書くと、OllamaはCodexの代わりにはならなかった。
むしろ、代わりにしない方がよかった。
決まった仕事をローカルへ寄せ、設計、例外判断、公開前の確認はCodexへ残す。
この分け方にして、クラウド側へ毎回送っていた反復処理を減らせた、という話です。
Codexへ渡すには惜しい反復が増えていた
Codexへ任せたいのは、本来、曖昧さがある仕事だった。
複数の資料を読み、変更範囲を決め、実装し、失敗時の戻し方まで考える。こういう仕事では、長い文脈を扱えることや、ファイルとツールを横断できることが効く。
一方で、日々の運用にはもっと小さい判断がある。
候補を条件に沿って分類する。短い文案を決められたJSONへ入れる。明らかに対象外のものを落とす。同じ入力から同じ項目を抜き出す。
ここまで毎回Codexへ渡す必要があるのか。
週次利用量の表示を見るたび、そこが引っかかるようになった。
Codexのモデル選びを66件の実運用から見直したときも、明確な反復と、曖昧で失敗影響が大きい仕事は分けた方がよいと整理している。
今回は、モデルを選び分けるところから、さらに一部をローカルへ出した。
CodexのGPT-5.6 Sol・Terra・Lunaを66件の実運用で使い分けた結論
常時稼働のMac miniへOllamaを置いた
使っているのは、M4、24GB unified memory、1TB SSDのMac miniです。
もともとCodexの長い作業や複数の役割を置く常時稼働機として使っていた。
このMac miniへ、2026年8月8日時点でOllama 0.32.5を入れている。
Ollamaの公式ドキュメントでは、macOS Sonoma以降とApple M seriesがサポートされ、DMGからApplicationsへ入れる方法が推奨されています。
自分の環境では、既存のCLI管理に合わせてHomebrewを使った。
Homebrew公式formulaにもOllamaがあり、導入は次の形です。
brew install ollama
brew services start ollamaモデルはqwen3:8bを取得した。
ollama pull qwen3:8b
ollama run qwen3:8b
Ollamaのmodel libraryでは、qwen3:8bは8.19B parameters、Q4_K_M、配布容量5.2GB、Apache 2.0として掲載されている。
ここでいう5.2GBはmodel fileの容量です。実行中のメモリ使用量が常に5.2GBという意味ではない。
Ollamaは常駐させても、8Bモデルは常駐させない
最初に分けたのは、Ollamaのserver processと、実際に読み込むmodelです。
Ollama本体はHomebrewのserviceとして動かし、Mac miniの起動後に使える状態へ置いた。
APIはhttp://127.0.0.1:11434だけを使う。
Ollama公式のlocal APIも、既定ではhttp://localhost:11434/apiです。自分のprogramは同じMacの中から/api/chatへrequestを送る。
ただし、8B modelまでずっとmemoryへ残す必要はなかった。
requestのkeep_aliveを10mにし、最後の処理から10分後に解放する。次の実行時には読み込み時間が出るが、使っていない時間までmemoryを占有し続けない方を選んだ。
自分の設定は、JSON structured output、think=false、num_ctx=4096。
長い推論や広い文脈を求めるのではなく、与えた候補を決めたschemaへ分類するための設定です。
OllamaのChat APIは、formatへjsonまたはJSON schemaを指定できる。
とはいえ、schemaを渡せば内容まで正しいとは限らない。program側でも必須項目、型、許可値を検証し、不正なら実行へ進めないようにした。
役割は4層に分けた
ここが今回いちばん大切だった。
ローカルLLMを入れたからといって、全部をOllamaへ渡したわけではない。
| 層 | 担当 | 役割 |
|---|---|---|
| 1 | ルール処理 | 日付、重複、件数、許可条件など、コードで確定できる候補を絞る |
| 2 | Ollama | 残った候補の分類、短い下書き、JSON structured output |
| 3 | 決定論的な実行program | schema検証、状態確認、許可された処理、結果保存、失敗時停止 |
| 4 | Codex | 設計、例外判断、変更、独立確認、最終的な採否 |
Ollamaがブラウザを操作しているわけではない。
Ollamaが返すのは、分類や文案を含む構造化された候補です。それを受け取った別のprogramが、固定した手順と停止条件の中で処理する。
しかも、LLMへ渡す前にルールで落とせるものは落とす。
重複、上限、対象期間、必須情報の欠落は、言語modelに考えさせる必要がない。ここを先にcodeで絞ると、Ollamaへ渡す入力も短くなる。
最後に、例外と変更はCodexへ戻す。
新しい形式が混ざった。判断基準を変えたい。出力が不安定。公開へ進めるか迷う。こういう時は、ローカルmodelへ押し込まず、設計側の仕事として扱っている。
Codexから移した仕事、残した仕事
ローカルへ移したのは、正解の形を先に決められる仕事です。
- 候補を少数のlabelへ分類する
- 定型の短文を下書きする
- 決まったfieldをJSONで返す
- 同じ評価基準を複数件へ繰り返す
- 実行前に、人が確認できる候補を作る
逆に、Codexへ残した仕事は変えていない。
- workflow全体の設計と変更
- 公式情報や複数資料を読んだ判断
- 失敗影響が大きい例外処理
- codeやdocumentの修正
- 公開、安全、規約、事実関係の最終確認
- ローカルLLMの出力が妥当かを点検する仕事
文章を生成できるからといって、記事そのものをすべてローカルへ移すつもりもない。
taupeの記事なら、過去記事、文体、事実確認、WordPress、内部link、商品導線、公開QAまでつながる。短文の下書きとは仕事の形が違う。
ローカルLLMへ向いていたのは、「何を返すか」をschemaで狭くできる部分だった。
利用量は減る。ただし、削減率はまだ測っていない
仕組みとしては単純です。
以前Codexへ送っていた分類と短い生成を、同じMac mini内のOllamaへ送る。クラウド側へ渡すrequestの回数と入力が、その分だけ減る。
実際、反復処理の途中でCodexを呼ばずに済む場面は増えた。
週次利用量を、同じ分類の繰り返しではなく、設計や例外判断へ残しやすくなった実感がある。
Codexの使用量リセット、5時間枠・週次枠、30日期限については、Codexの使用量リセットを実測で整理した記録に分けている。
この記事では、リセット機能を使う前に、反復処理そのものを減らす側を見ている。
ただ、削減率はまだ計測していない。
何%減った、月いくら得した、という数字は出せません。作業ごとのtoken量も、ローカル実行にかかる電力や保守時間も、同じ条件では比べていない。
今言えるのは、「クラウド側へ送る反復処理を減らせた」という仕組みと実感まで。
効果を数字で出すなら、移行前後の同一期間、処理件数、Codex利用量、失敗と再実行、保守時間を揃えて観測する必要がある。
24GBでも、何でもローカルへ移せるわけではない
24GBのMac miniでqwen3:8bを使う今回の範囲は、日常運用へ入れられた。
でも、cloud modelと同じ感覚ではない。
まず、modelを解放した後の最初のrequestには、再読み込みの待ちがある。
常時loadすれば待ちは減るが、memoryを空ける運用とは両立しない。自分は即応性より、使っていない時に解放する方を選んだ。
次に、知識が古い。
ローカルmodelが現在の公式仕様を知っている前提にはできない。変更されるAPI、価格、policy、製品情報は、別に一次情報を取得して入力するか、Codex側で確認する必要がある。
そして、保守は自分へ戻ってくる。
Ollamaの更新、modelの更新、prompt、schema、timeout、retry、ログ、失敗時の停止。cloudへ任せていた部分をローカルへ移せば、管理する対象も増える。
速度も、今回は数値を出していない。
短い分類に使える感触はあるが、tokens/secや平均応答時間を計測した比較ではありません。大きなmodel、長いcontext、大量並列まで24GBで快適だとは言えない。
ローカルだから自動的に安全、でもない。
localhostに閉じ、入力を絞り、認証情報を渡さず、出力を検証し、実行programに停止条件を置く。設計が必要なのはcloudと同じです。
小さく始めるなら、分類を一つだけ移す
いきなり既存workflowを置き換えない方がいい。
自分も、最初は結果を比較するだけのshadow運用から始めた。
小さく試すなら、入力が短く、labelが三つ程度で、間違えても公開や更新へ進まない分類が向いている。
OllamaにはJSON schemaで候補を返させ、人が結果を見る。実行はまだつながない。
そこで分類の揺れ、読み込み時間、memory、失敗時の出力を確認する。
安定してから決定論的なprogramへ渡し、それでも公開や外部変更の前には確認点を残す。
AI agent全体の役割や安全な分担を先に整理したい人には、入門書を一冊置いておくと考えやすい。
以下は自分の実使用書籍という意味ではなく、local LLMをどこへ組み込むか考える次の読書候補として選んでいます。

まとめ。OllamaはCodexの代替ではなく、補助役だった
Codexの利用量が気になり、Mac miniへOllamaを常駐させた。
やってみて分かったのは、local LLMへ仕事を丸ごと渡す必要はないということだった。
ルールで絞る。
Ollamaで分類と短い生成をする。
決定論的なprogramが検証して実行する。
Codexは設計、例外、変更、最終確認を担う。
この4層に分けると、Codexへ残したい仕事がはっきりした。
未計測なので削減率は言えない。でも、同じ反復をcloudへ送り続ける回数は減った。
local LLMを置く目的は、全部を置き換えることではなかった。
Codexを、Codexに任せたい仕事へ戻すための補助役。今の自分には、その距離がちょうどよかった。